ИИ: Ключевые термины
Что такое данные, готовые для агентов
Что такое данные, готовые для агентов? Требования, примеры и подготовка
Данные, готовые для агентов — это корпоративные данные, подготовленные так, чтобы агент мог надежно находить, интерпретировать, сопоставлять и использовать их прямо во время работы. Для этого у данных должны быть бизнес-контекст, достаточная актуальность и контроль доступа, которые позволяют выполнить задачу безопасно.
Источники могут быть структурированными, как базы данных и таск-трекеры, или неструктурированными, как документы, чаты и расшифровки встреч. Чтобы подготовить данные для агентов, необязательно переносить все в одно хранилище или внедрять конкретную технологию: RAG, MCP, векторную базу или граф знаний.
Что такое данные, готовые для агентов?
Это данные, с которыми ИИ-агент может работать в ходе задачи самостоятельно. Ему не нужен человек, который объяснит, что означает каждая запись, какой источник актуален и как связаны между собой разные фрагменты информации.
Например, одного доступа к задаче в Jira, коммиту в Git, сообщению в Slack и бюджету проекта недостаточно. Агенту может понадобиться знать, что коммит относится к этой задаче, к какому проекту она принадлежит, отменяет ли решение из Slack более старый документ и разрешено ли пользователю видеть финансовые данные.
Поэтому готовность данных для агентов не сводится к их качеству. Сюда входят еще бизнес-смысл, связи, подходящая актуальность, права доступа и контекст, который можно определить во время выполнения.
Термин пока не устоялся, и разные платформы описывают его по-разному. Единой архитектуры или универсального чек-листа, обязательного для каждой организации, не существует.
Данные для агентов и данные для ИИ: в чем разница
Данные, готовые для ИИ (AI-ready), и данные, готовые для агентов (agent-ready), во многом пересекаются, но акценты в требованиях у них разные.
| ИЗМЕРЕНИЕ | ДАННЫЕ, ГОТОВЫЕ ДЛЯ ИИ | ДАННЫЕ, ГОТОВЫЕ ДЛЯ АГЕНТОВ |
|---|---|---|
| Цель | Анализ или генерация | Решения и потенциальные действия во время выполнения |
| Семантика | Полезна | Критически важна для интерпретации |
| Актуальность | Зависит от кейса использования | Часто более критична |
| Права доступа | Требование управления | Должны сохраняться при получении и действиях |
| Взаимосвязи | Могут оставаться неявными | Должны определяться машинно |
| Результат | Аналитический вывод или сгенерированный контент | Вывод и возможное действие |
Данные для ИИ в привычном понимании готовят так, чтобы модели и ИИ-приложения могли надежно их обрабатывать. Это может включать очистку, нормализацию, разметку, проверки качества и обогащение.
У данных для агентов появляется дополнительное требование, связанное с выполнением. Агент сам выбирает, какую информацию извлечь, и может использовать ее для следующих шагов. Поэтому ему нужно понимать не только значения в наборе данных, но и что они означают, как связаны с другими сущностями, достаточно ли они актуальны для задачи и к чему разрешен доступ пользователю или агенту, который делает запрос.
Граница здесь не жесткая. Хорошо спроектированный фундамент данных для ИИ может уже закрывать многие требования агентов. Готовность для агентов описывает дополнительные условия, нужные для автономного использования во время выполнения.
Что делает данные пригодными для агентов?
Не существует универсального шестипунктного стандарта для таких данных, но многие требования регулярно встречаются в современных агентских архитектурах данных.
Явный семантический смысл
Агенты нуждаются в определениях важных сущностей, метрик, полей и бизнес-понятий, пригодных для машинной обработки.
Например, поле с названием status полезно только в том случае, если система способна определить, что значат возможные значения и нет ли разночтений этого понятия между разными инструментами. Бизнес-термины, такие как доход, статус проекта, активный клиент или завершенная задача, также требуют четких определений.
Семантический контекст снижает объем интерпретаций, которые модель должна делать самостоятельно.
Связанные отношения
Корпоративные вопросы часто затрагивают несколько систем. Агент может потребоваться связать клиента с контрактом, проект с репозиторием, тикет с коммитом или решение с совещанием, где оно было принято.
Эти связи должны быть обнаруживаемы, а не существовать только в голове у сотрудников. Их можно реализовать по-разному: через идентификаторы, метаданные, слои сопоставления, графы или логику приложений.
Корректная актуальность
"Готовность для агентов" не означает, что каждый источник должен обновляться в реальном времени.
Актуальность должна соответствовать принимаемому решению. Адрес компании может оставаться актуальным месяцами, а агент, который отвечает на вопрос "Какие инциденты в продакшене остаются открытыми?", может потребовать данные за последние минуты.
Главное — знать, насколько свежа информация, и достаточно ли этого для задачи.
Доступ с учетом разрешений
Агент не должен получать более широкий доступ только из-за того, что может обращаться сразу к нескольким системам.
Права доступа к источнику, проекту, роли пользователя и другие правила должны сохраняться при получении и объединении информации. Особенно это важно, если агент может инициировать действие на основании полученных данных.
Трассируемость и происхождение
Система должна определять, откуда поступила важная информация.
Ссылки на источник, временные метки, владельцы и история преобразований помогают пользователям проверять ответы и расследовать противоречия в данных. Происхождение также позволяет агенту отличать авторитетные записи от вторичных или устаревших источников.
Это тесно связано с привязкой ИИ к данным, где ответы привязываются к внешней, проверяемой информации, а не только к знаниям моделей.
Машиночитаемые бизнес-правила и контекст
Сырые записи редко содержат все правила, нужные для их корректной интерпретации.
Агенту может быть необходимо знать, как компания определяет просроченную задачу, какие стадии проекта требуют одобрения, как рассчитывается приоритет или какой источник «побеждает», если два источника расходятся.
Вот тут становится важной инженерия контекста. Надежные агенты нуждаются не только в извлечении информации, но и в получении верного контекста вокруг текущей задачи.
Что происходит, если данные не готовы для агентов?
Данные могут быть доступны технически, но все равно приводить к ненадежному поведению агента.
Устаревший контекст может вынудить агента сообщить устаревший статус проекта или действовать по уже измененной информации. Несогласованные идентификаторы могут не позволять системе распознать, что D. Smith, имя пользователя в Git, и аккаунт в Slack — это один и тот же человек.
Недостаток семантики может привести к ошибочной интерпретации полей или метрик. Проблемы с разрешениями могут открыть доступ к информации, которую текущему пользователю нельзя видеть, или позволить агенту выйти за рамки своих прав.
Нарушенные связи дадут разрозненные ответы, потому что агент не сможет связать тикет, беседу, смену в репозитории и веху проекта. Отсутствие происхождения затруднит верификацию ответа и разбирательство в случае противоречий.
Большинство таких сбоев — это проблемы контекста, а не ошибки самой модели. Улучшение одной только модели не подскажет ей, какая запись по проекту является основной или разрешено ли пользователю к ней обращаться.
Как понять, что ваши данные готовы для AI-агентов?
Готовность стоит оценивать под конкретный сценарий, а не как свойство всей компании по принципу "да или нет".
Для каждого источника, который нужен агенту, задайте вопросы:
1. Может ли агент получить данные без ручной выгрузки?
2. Достаточно ли четко определены важные поля, сущности и бизнес-термины для машинного использования?
3. Можно ли связать родственные сущности из разных источников?
4. Достаточно ли свежи данные для решений, которые будет принимать агент?
5. Сохраняются ли при извлечении права пользователя, проекта и источника?
6. Может ли агент проследить важные факты до их источника?
7. Доступны ли нужные бизнес-правила и исключения в машиночитаемом виде?
8. Есть ли правило на случай противоречивой или отсутствующей информации?
Один источник может быть пригоден для одного агента и неприменим для другого. Ежемесячные финансовые данные могут быть достаточны для стратегической отчетности, но недостаточны для агента, который должен немедленно отмечать изменения в бюджете.
Такой подход избавляет и от лишней инфраструктурной работы. Командам не нужно доводить все корпоративные данные до одинаковой свежести, связности и доступности, чтобы запустить первого агента.
Пример: данные, готовые для агентов, в управлении проектами
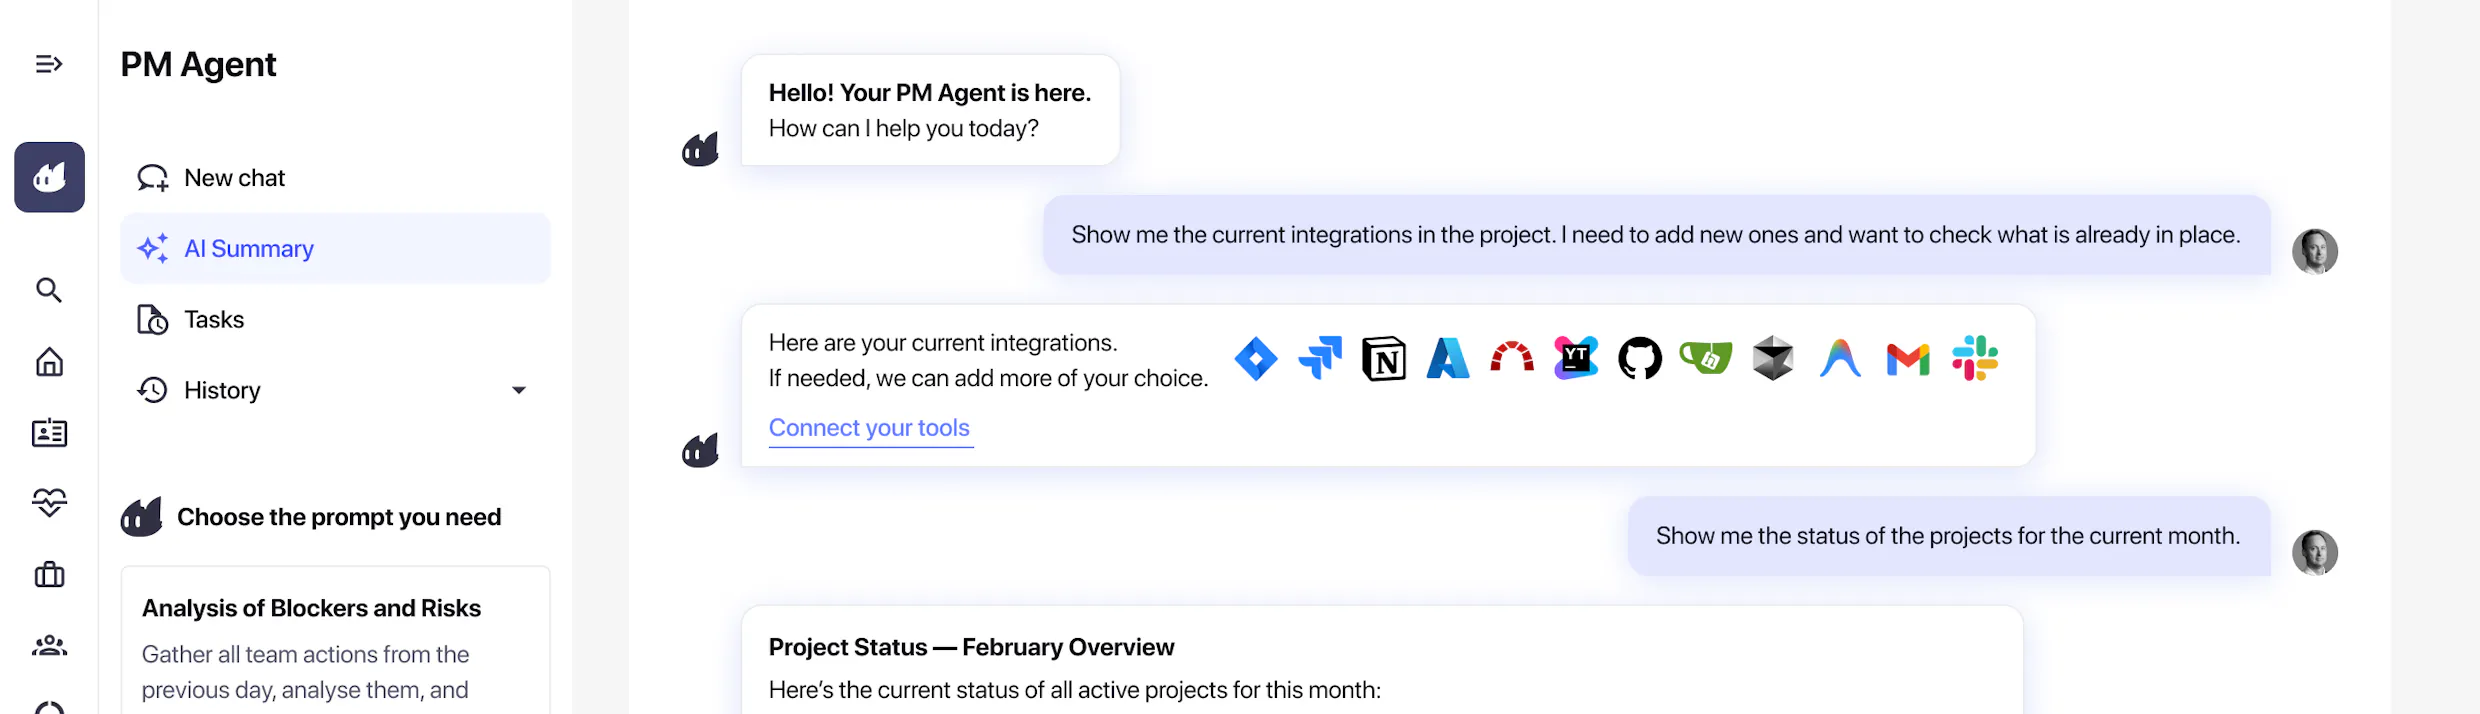
Управление проектами наглядно показывает, что просто объединить данные — не значит сделать их понятными для агента.
Агент по проектам может работать с задачами в Jira или Linear, активностью в Git, перепиской в Slack или Teams, документами, расшифровками встреч, рабочими журналами, финансовыми данными и специфическими для проекта правилами.
Связав все эти источники, мы получим доступ к сырой информации, но это не создаёт единой связной картины проекта.
Чтобы ответить на вопрос "Есть ли риск у релиза?", агенту, возможно, придется понять, что несколько коммитов относятся к одной фиче, что она блокирует веху, что встреча изменила срок, что незакрытая задача в Jira относится к тому же рабочему потоку, а текущий бюджет едва покрывает дополнительные работы.
Источники требуют разных уровней свежести и прав. Разработчик может видеть репозиторий и трекер, но не финансовые показатели проекта. Решение с сегодняшней встречи может отменить плановый документ, созданный месяц назад.
Структурированный контекст проекта делает отношения и правила достаточно явными, чтобы агент мог оперировать ими. Об этой проблеме подробнее читайте в связанном материале:
Подготовка данных для агента не всегда означает переезд в новое хранилище. В управлении проектами чаще нужно связать существующие системы и добавить достаточно контекста, чтобы агент понимал, что эти записи означают вместе.
От подключенных данных к контексту проекта
Главное по теме
- Данные, готовые для агентов, дают ИИ-агентам достаточно смысла, контекста, актуальности, связей, прав и сведений о происхождении, чтобы надежно использовать корпоративные данные во время выполнения.
- Данные для ИИ и данные для агентов пересекаются, но во втором случае больше внимания уделяется интерпретации во время выполнения, управляемому доступу и возможным последующим действиям.
- Данные не обязательно должны быть централизованы или обновляться в реальном времени повсюду — готовность определяется задачами конкретного агента.
- Семантика и машинно определяемые связи помогают агентам интерпретировать данные из разных систем, а не рассуждать над разрозненными записями.
- Права и сведения о происхождении должны сохраняться при извлечении, чтобы агенты использовали только разрешенные данные, а пользователи могли проверить важные результаты.
- Готовность данных стоит оценивать по каждому сценарию отдельно: один и тот же источник может подходить одному агенту и не годиться для другого.
FAQ
Что такое данные, готовые для агентов?
В чем разница между данными, готовыми для AI, и данными, готовыми для агентов?
Должны ли данные для агентов быть в реальном времени?
Должны ли данные, готовые для агентов, храниться в одном месте?
Обязательно ли нужен семантический слой для данных, готовых для агентов?
Достаточно ли RAG, чтобы данные стали готовы для агентов?
Требуют ли данные для агентов MCP?
Последнее обновление: октябрь 2026 г.